OpenAI presenta el rendimiento de Jalapeño, su primer chip para inferencia de IA: promete ser más rápido y eficiente
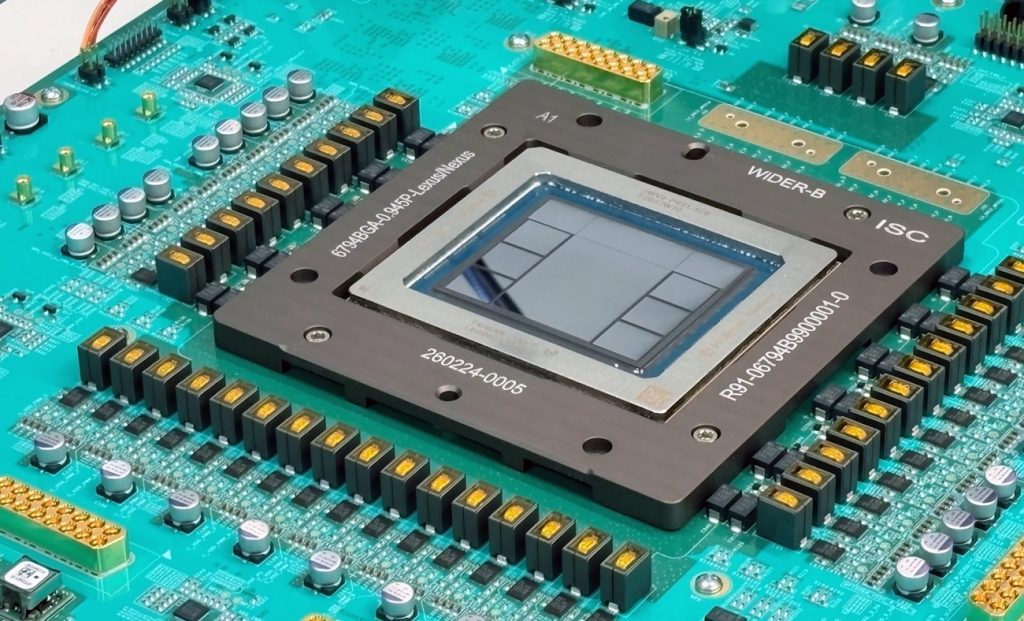
OpenAI ha compartido el rendimiento de su primer chip personalizado para la inferencia de modelos de Inteligencia Artificial (IA) que beneficiará a los usuarios con respuestas más rápidas, agentes más ágiles y un acceso más fiable.
Anunciado en junio, Jalapeño ha sido desarrollado por OpenAI en estrecha colaboración con Broadcom. El objetivo de la compañía es que Jalapeño sea una plataforma multigeneracional, que permita el desarrollo conjunto de productos, modelos, chips y memoria de IA.
"Jalapeño puede servir más trabajo de IA por unidad de energía, mientras también responde más rápidamente. Es muy eficiente al servir a múltiples clientes, pero también puede ser muy bajo en latencia", afirma el director de hardware de OpenAI, Richard Ho, en el comunicado de prensa, según recoge el medio TechCrunch.
El primer chip personalizado de OpenAI ha sido diseñado con sus modelos de IA, mientras que los modelos más recientes se han usado para optimizarlo y programarlo. El objetivo de OpenAI es integrarlo en su propia infraestructura de cómputo hacia finales de año, según la publicación hecha por OpenAI.
"El rendimiento de Jalapeño se extiende a GPT-OSS 120B, DeepSeek R1 y Kimi K2.5 1T, lo que indica que la arquitectura funciona en modelos internos y externos", subraya OpenAI en su anuncio publicado en su web.
De hecho, en los tres modelos mencionados, Jalapeño ha demostrado un gran rendimiento al servir de 1,5 a 1,9 veces más trabajo de IA por vatio (a consumo pico) y de 1,7 a 3,6 veces menos latencia (fin a fin) que sistemas similares.
En lo que respecta al rendimiento con agentes de IA y tareas altamente interactivas, Jalapeño es de 2,1 a 4,1 veces superior a sistemas similares, y en el consumo, con una potencia nominal de 700 W, en pruebas reales se mantuvo en 550 W o por debajo.
Más concretamente, en GPT-OSS (120B) ofrece un rendimiento por kW 1,9 veces mayor, en DeepSeek R1 (670B), 1,7 veces mayor, y en Kimi K2.5 (1T), 1,5 veces mayor.
Jalapeño ha sido probado en la plataforma de benchmark pública InferenceX, y ofrece más tokens por usuario y más procesamiento por kilovatio que los procesadores de inferencia comerciales punteros con los que se compara, como la arquitectura Blackwell GB200/GB300 de Nvidia,
TEMAS RELACIONADOS: #EUROPA PRESS
NO TE PIERDASAnthropic unifica la memoria de Claude en el chat y Cowork y da más control sobre la información que guardaTE PUEDE GUSTAR
Google actualiza el Modo IA y AI Overviews con enlaces más claros, contexto sobre las fuentes y artículos de actualidad
La inteligencia artificial transforma el trabajo: 5 oportunidades de negocio para asistentes virtuales en 2026 y cómo Chatea puede ayudarlos a crecer
Google eliminará en diciembre 'Señal de seguridad', la función de emergencias sin plan móvil de los Pixel Watch 2 y 3
Microsoft lanza Microsoft-Decision-1, un modelo basado en Qwen que toma decisiones 35 veces más rápido que GPT-6 Sol
OPPO presentará la serie OPPO Find X10, con el primer smartphone con triple cámara de 200MP, el 21 de octubre